AI Engineering · 13–19 октября 2026

Инженерия агентов: что проверять на практике

Исследования агентного кодинга, оценки, инструментов и безопасности вместе с двумя инженерными разборами. Каждый материал связан с первоисточником; численные результаты описаны в пределах условий авторов.

Начать с этих пяти

  1. Enforcing Code Reasoning in Agentic Scaffold for More Effective Issue ResolutionТрассировка пути исполнения и проверка требований перед патчем повысили долю решённых задач SWE-bench-Pro в сравнении авторов.
  2. Robust Function Calling for LLM Agents Under Interface DriftПроверка актуальной схемы вызова инструмента и одна ограниченная попытка исправления помогают агенту переживать изменения интерфейса.
  3. GatewayBench: Unified Capability and Security Evaluation Platform for MCP GatewaysАрхитектура MCP-шлюза меняет успешность задач и устойчивость к косвенной prompt injection при большом каталоге инструментов.
  4. Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding AgentsСпецификацию agent harness можно проверять исполняемыми контрактами с управляемой моделью.
  5. Monitor-Validity Failures: LLM Safety Evidence Paths at Evolving Framework BoundariesПроверка safety-монитора должна ставить контрольный маркер именно на изменённый путь данных и проверять два результата: видит ли его монитор и выполняет ли нужное действие.
20 материалов

Исследования 18

coding · 2026-10-19

Enforcing Code Reasoning in Agentic Scaffold for More Effective Issue Resolution

Changshu Liu, Ji young Kim, Alireza Ghazanfari и др.

Трассировка пути исполнения и проверка требований перед патчем повысили долю решённых задач SWE-bench-Pro в сравнении авторов. Полезно как проверяемый сценарий для агента, исправляющего баги.

Открыть первоисточник ↗
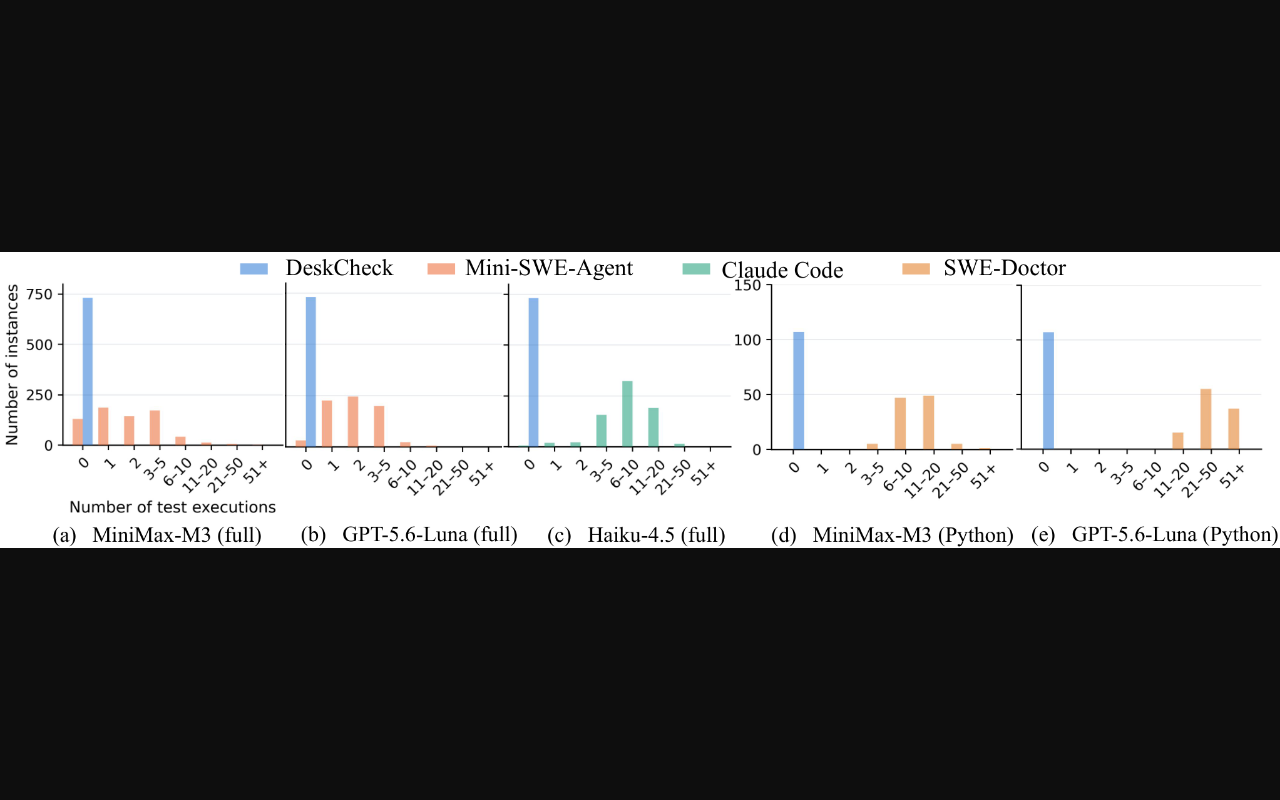
Число запусков тестов в DeskCheck и базовых агентах; график относится к эксперименту авторов.
Число запусков тестов в DeskCheck и базовых агентах; график относится к эксперименту авторов. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Сравнивали один и тот же модельный состав на 731 задачах. Отличия составили 6,29–10,53 процентного пункта; в scaffold объединены несколько приёмов.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Скрытые тесты могут отвергать корректные альтернативные исправления; отдельный вклад каждого шага не установлен.

Для моей работы. Проверить собственные задачи с трудным воспроизведением: отдельные шаги локализации, симуляции патча и проверки краевых случаев.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

agents · 2026-10-19

Robust Function Calling for LLM Agents Under Interface Drift

Aniruddha Chattopadhyay, Kanishka Halder, Partha Sarathi Roy

Проверка актуальной схемы вызова инструмента и одна ограниченная попытка исправления помогают агенту переживать изменения интерфейса. Особенно важна путаница между похожими инструментами.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. На Qwen3.5-9B авторы сравнили вызовы до и после сдвига схемы в DICE-300 и BFCL-200; точность выросла с 0,717 до 0,813 и с 0,580 до 0,805.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Сдвиги синтетические; repair добавляет 32,6–47,1% токенов и не исправляет допустимый по схеме, но неверный по смыслу вызов.

Для моей работы. Ввести в шлюзе проверку имени и аргументов до исполнения, ограниченный repair и мониторинг конфликтующих описаний.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

agents · 2026-10-19

GatewayBench: Unified Capability and Security Evaluation Platform for MCP Gateways

Yitian Zheng, Zhaorun Chen, Haoyu Li и др.

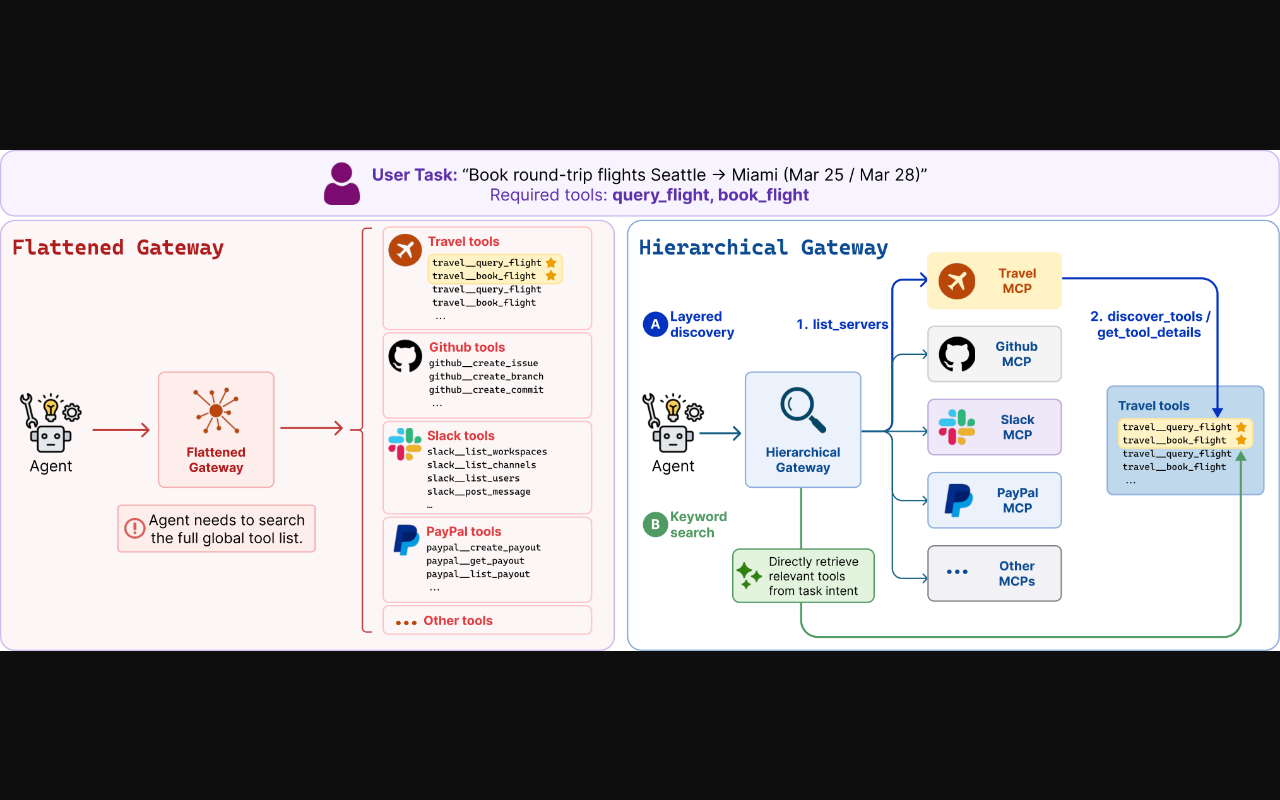
Архитектура MCP-шлюза меняет успешность задач и устойчивость к косвенной prompt injection при большом каталоге инструментов. Иерархическое обнаружение уменьшило успех атаки в опытах авторов.

Открыть первоисточник ↗
Плоский и иерархический MCP-шлюзы: разные способы показать агенту инструменты.
Плоский и иерархический MCP-шлюзы: разные способы показать агенту инструменты. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Семь шлюзов, 450 доброкачественных и атакующих задач, до 1500 лишних инструментов. При нулевом шуме средний успех атаки был 19,6% против 60,5% для иерархического и плоского вариантов.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Обычно один прогон на конфигурацию; более слабая модель иногда хуже решает штатные задачи при иерархии.

Для моей работы. Проверять одновременно успешность полезных задач, атаки и задержку на своём наборе инструментов.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

coding · 2026-10-15

Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents

Yuyao Ge, Shenghua Liu, Peizhong Gao и др.

Спецификацию agent harness можно проверять исполняемыми контрактами с управляемой моделью. Даже лучшие модели не проходят почти половину поведенческих случаев.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Авторы собрали 328 проверок для 12 harness и 19 моделей; лучший средний pass rate составил 53,05%. Тесты проверяли запросы к модели, файловую систему, команды и коды выхода.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Это построение с ограниченными попытками без цикла исправления; варианты одного теста коррелируют, а mock-модель не показывает итоговую полезность с живой LLM.

Для моей работы. Для собственного runtime перевести права, состояние сессии и операции с файлами в детерминированные позитивные и негативные проверки.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

security · 2026-10-16

Monitor-Validity Failures: LLM Safety Evidence Paths at Evolving Framework Boundaries

Junchi Liao

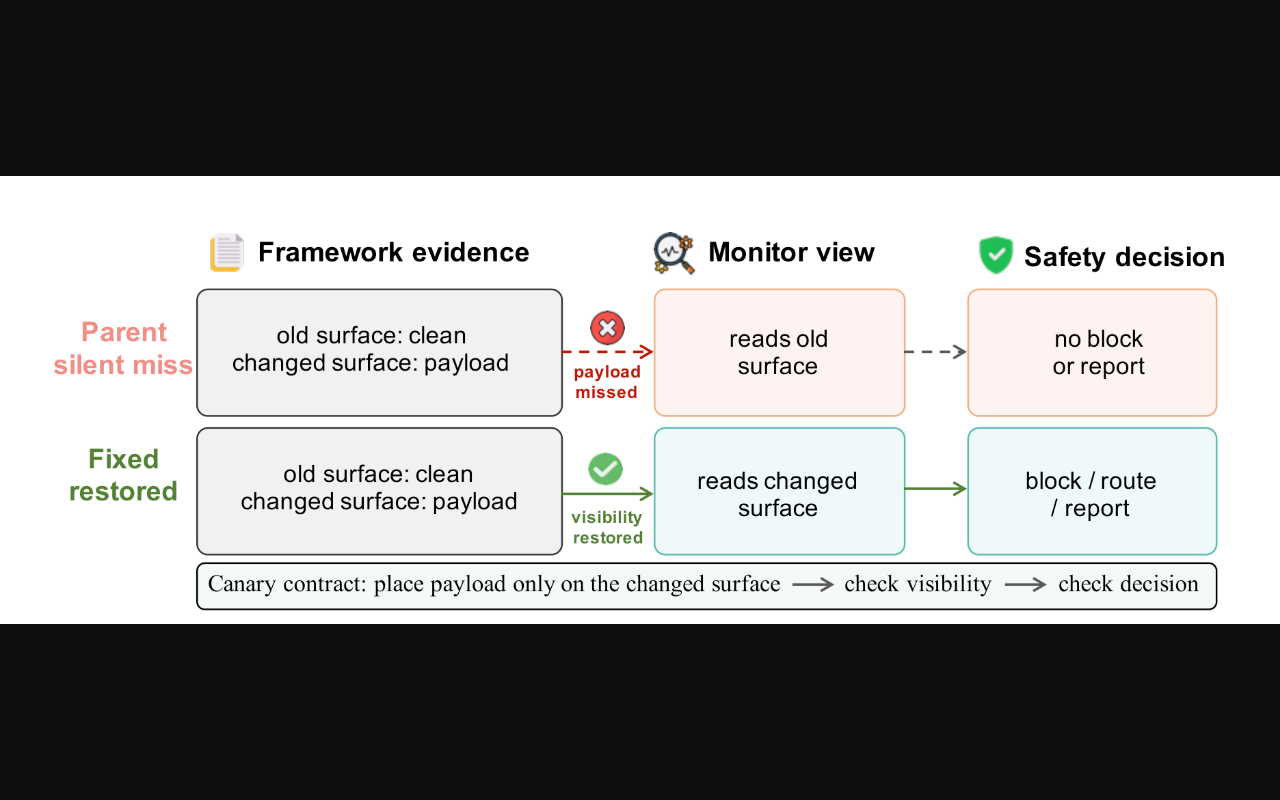
Проверка safety-монитора должна ставить контрольный маркер именно на изменённый путь данных и проверять два результата: видит ли его монитор и выполняет ли нужное действие. Это способ обнаружить сломанный адаптер после изменения framework.

Открыть первоисточник ↗
Схема проверки monitor canary: маркер на изменённой поверхности, видимость и решение политики.
Схема проверки monitor canary: маркер на изменённой поверхности, видимость и решение политики. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Автор воспроизвёл 18 пар «неисправленный родительский коммит — исправленная версия» в 11 группах framework. В 14 случаях затронута граница исполнения политики, но только семь показывают нативное действие.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Ни один случай не доказывает историческую цепочку «работало — сломалось — исправили»; выборка специально собрана из исправлений, частота таких ошибок неизвестна. Go не проверялся.

Для моей работы. При изменении API, event stream или tool-call adapter добавить детерминированный canary только на новый путь и проверять видимость и решение отдельно.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

agents · 2026-10-19

MLOps-Bench: Benchmarking AI Agents on Production ML Engineering in Real Repositories

Quoc Co Tran, Hitesh Laxmichand Patel, Diwakar Mahajan и др.

MLOps-Bench отделяет прохождение отдельных тестов от полного завершения инженерной задачи. Разрыв между этими метриками заметен даже у сильного coding agent.

Открыть первоисточник ↗
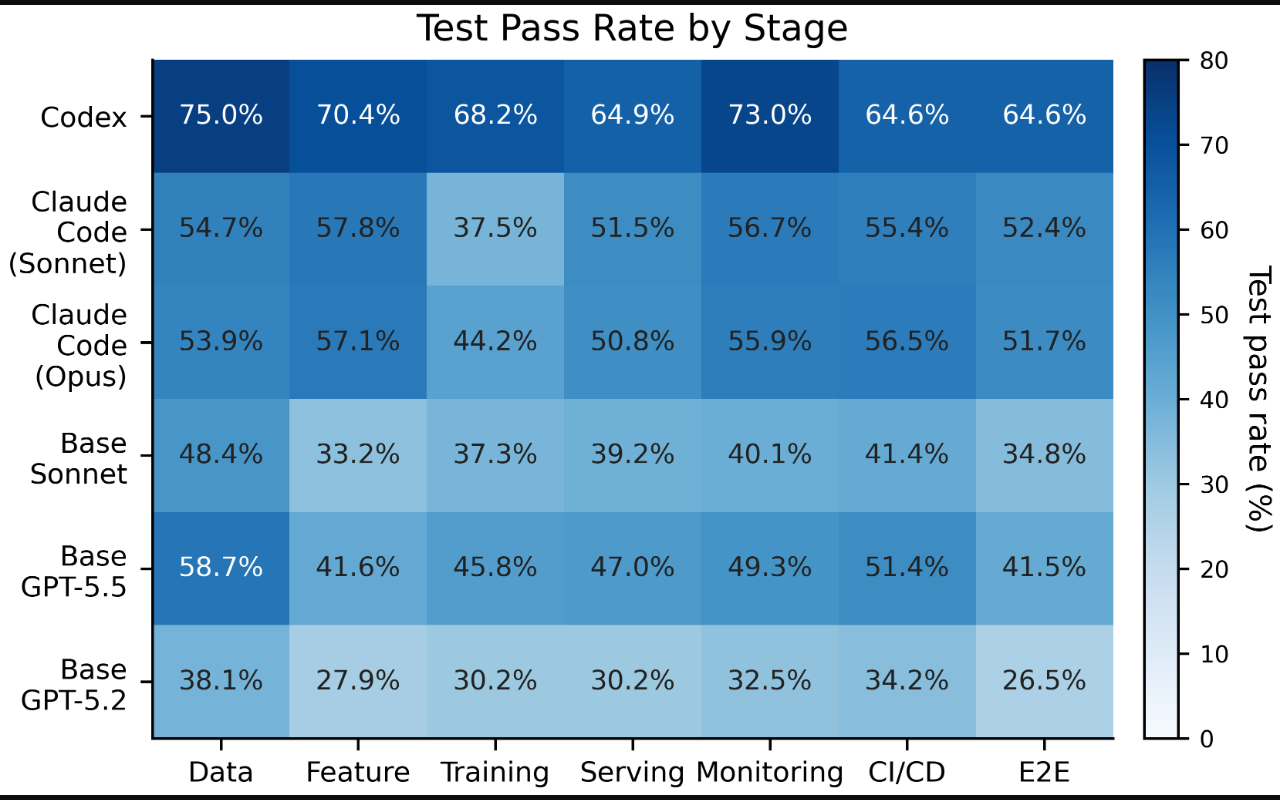
Тепловая карта прохождения тестов на этапах ML lifecycle для сравниваемых агентов.
Тепловая карта прохождения тестов на этапах ML lifecycle для сравниваемых агентов. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Авторы подготовили 212 задач из 31 открытого ML-репозитория; лучший агент решил 31,2% оценочных задач при 68,7% пройденных отдельных тестов.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Задачи синтезированы из репозиториев, а не из продакшен-инцидентов; конечный набор тестов может поощрять узкую реализацию.

Для моей работы. Во внутренних eval проверять целостный контракт изменения и сохранение старого поведения, особенно для serving и конфигурации.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

coding · 2026-10-19

Code Skill Server: A Large-Scale Search Engine for Code Generation Skills

Xiaoyong Li, Haolong Li, Dongliang Xu и др.

Поиск подходящих coding skills дал прирост в задачах генерации кода, но часть прежде решённых задач регрессировала. Полезнее оценивать retrieval как отдельный компонент агента.

Открыть первоисточник ↗
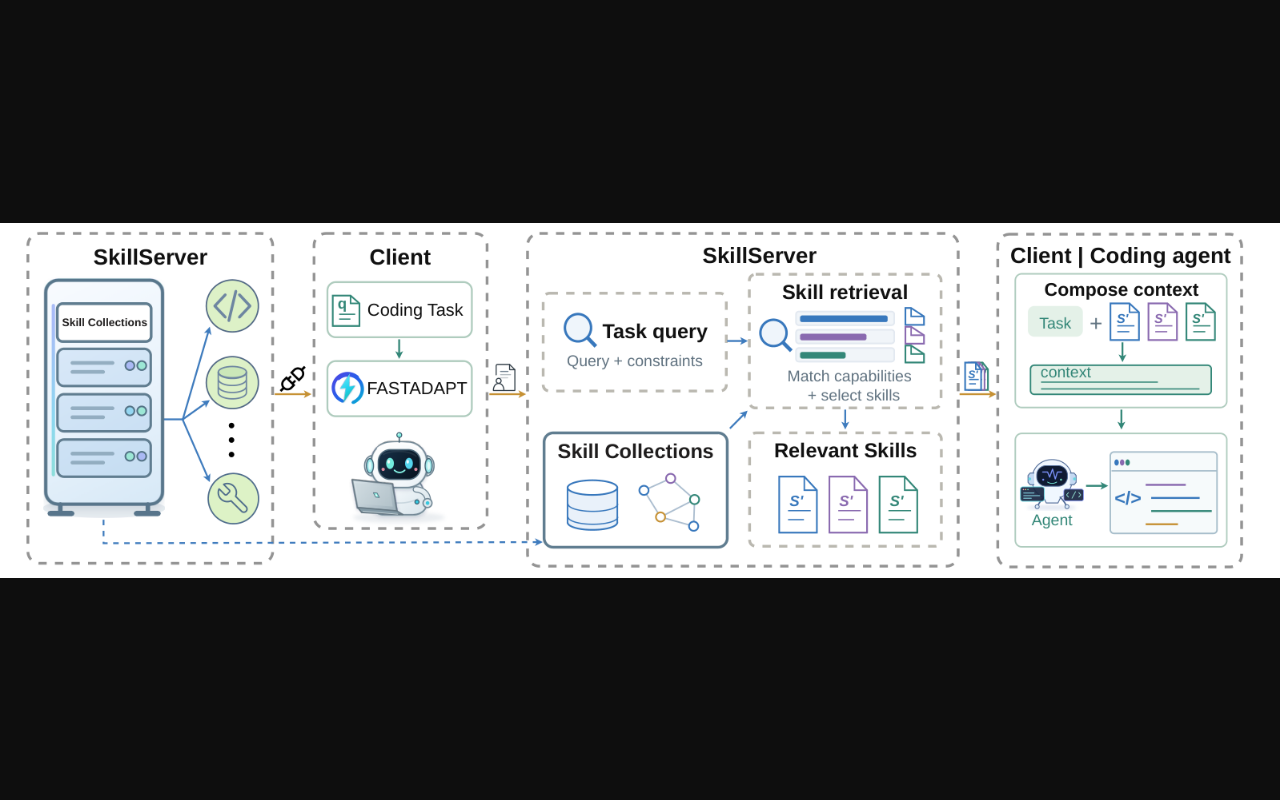
Путь от запроса coding agent до поиска подходящих навыков и составления контекста.
Путь от запроса coding agent до поиска подходящих навыков и составления контекста. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Индекс содержит 993 нормализованных навыка. Лучшие настройки повысили Pass@1 на BigCodeBench с 53,42% до 60,88% и на CoderEval-Python с 33,04% до 46,96%.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Бенчмарки в основном Python, не сопровождение Go-репозитория; на парных задачах BigCodeBench 27 случаев стали хуже.

Для моей работы. Сравнить выдачу малого числа релевантных навыков с вариантом без навыков и проверять происхождение внешних инструкций.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.
Первоисточник ↗

agents · 2026-10-19

EnterpriseSynth: Zero-Execution SFT and Evaluation Data from OpenAPI Specs

Rashmi Thimmaraju, Natan Vidra, Setty Spurthi

Из OpenAPI-спецификации можно создавать траектории вызова инструментов без обращения к живому API. Статическая проверка хорошо ловит ошибки структуры.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. В пилоте после исправлений валидатор обнаружил 43 из 44 внесённых структурных ошибок; обучение модели 0,5B использовало всего 45 траекторий.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Малый пилот и общая модель автора намерения и селектора дают риск само-согласованности; проверка схемы не замечает верные по типу, но неверные значения.

Для моей работы. Начать с разбора $ref и request body, генерации примеров и отклонения вызовов с неверной схемой; семантику аргументов измерять отдельно.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

coding · 2026-10-19

Between Spoilers and Guesswork: Avoiding Over-Specification in Coding Benchmarks

Yuanzhe Liu, Bastian Lipka, Avraham Shinnar и др.

Coding benchmark должен сообщать тестируемый интерфейс, не раскрывая готовое решение. Иначе агенту приходится угадывать имена новых API.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Авторы сравнили несколько уровней подсказки на четырёх Python benchmark и Java-наборе с тремя моделями в одном harness.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Подвыборки малы, на задачу один прогон; рост resolve от подробной подсказки сам по себе не доказывает честность benchmark.

Для моей работы. В собственных задачах явно описывать ожидаемый контракт новых идентификаторов и отдельно проверять, не утекла ли реализация.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

coding · 2026-10-16

WEAVE: Weaving Real-World Code Evolution into Dependency-Structured Tasks for Benchmarking and Training Code Agents

Weihao Li, Zihang Xu, Zhongqiu Wang и др.

WEAVE превращает последовательность связанных PR в задачи с зависимостями и наградой только за выполненные предпосылки. Это ближе к длинной миграции, чем независимые issue.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. На 1198 PR из 30 репозиториев и 219 размеченных связях average precision составила 37,7% против 26,6% у пересечения файлов.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Граф из истории PR не равен полной причинной структуре; 37,7% AP оставляет существенные ошибки, часть задач не удалось сделать исполняемыми.

Для моей работы. Проверять coding agents на связанных шагах миграции, фиксируя частичный прогресс только после обязательных предпосылок.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

coding · 2026-10-16

Poison Valleys: Diagnosing Path-Dependent Failure in LLM Code Repair

Veljko Skarich

Ошибочное утверждение в плане ремонта кода может закрепить неверный путь, даже если агент позже видит код. Оценка должна фиксировать не только pass/fail, но и нарушенное свойство.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. На двух сконструированных Python-задачах сравнили внедрение одной ложной идеи в гипотезу и план; в общих условиях план увеличивал неудачи на 32,2 и 28,9 пункта.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Сценарии синтетические; вывод не означает, что планирование как таковое вредно.

Для моей работы. Проверять план агента на фактические предпосылки до генерации патча и собирать тесты инвариантов.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

coding · 2026-10-16

Skip the Compressor: Coding Agents Fix More Issues When They Pick Whole Files

Xiaocong Yang, Rishit Chatterjee, Himanshu Udupi и др.

При том же бюджете контекста дословно выбранные целые файлы чаще приводили к успешному патчу, чем сжатые фрагменты. Потеря точных строк мешает применению изменения.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. На 300 Python issue SWE-rebench успех составил 43,7% и 46,7% для двух моделей, на 6,3 пункта выше лучшего токенного компрессора в основной настройке.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Одношаговый патч без открытия дополнительных файлов и тестов; улучшенный компрессор после того же отбора файлов сравнялся по resolve.

Для моей работы. Сначала улучшать локализацию нужного файла, затем сохранять его строки без переписывания; измерить на своих issue.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-15

SWE-Stream: Scaling Executable Training Data for SWE Agents via Progressive Construction and Elastic Streaming

Chengyang Liu, Wen Yang, Shifeng Chen и др.

SWE-Stream строит исполняемые задачи для обучения coding agents из истории PR с повторной проверкой окружения и тестов. Планирование этапов повышает выход годных задач.

Открыть первоисточник ↗
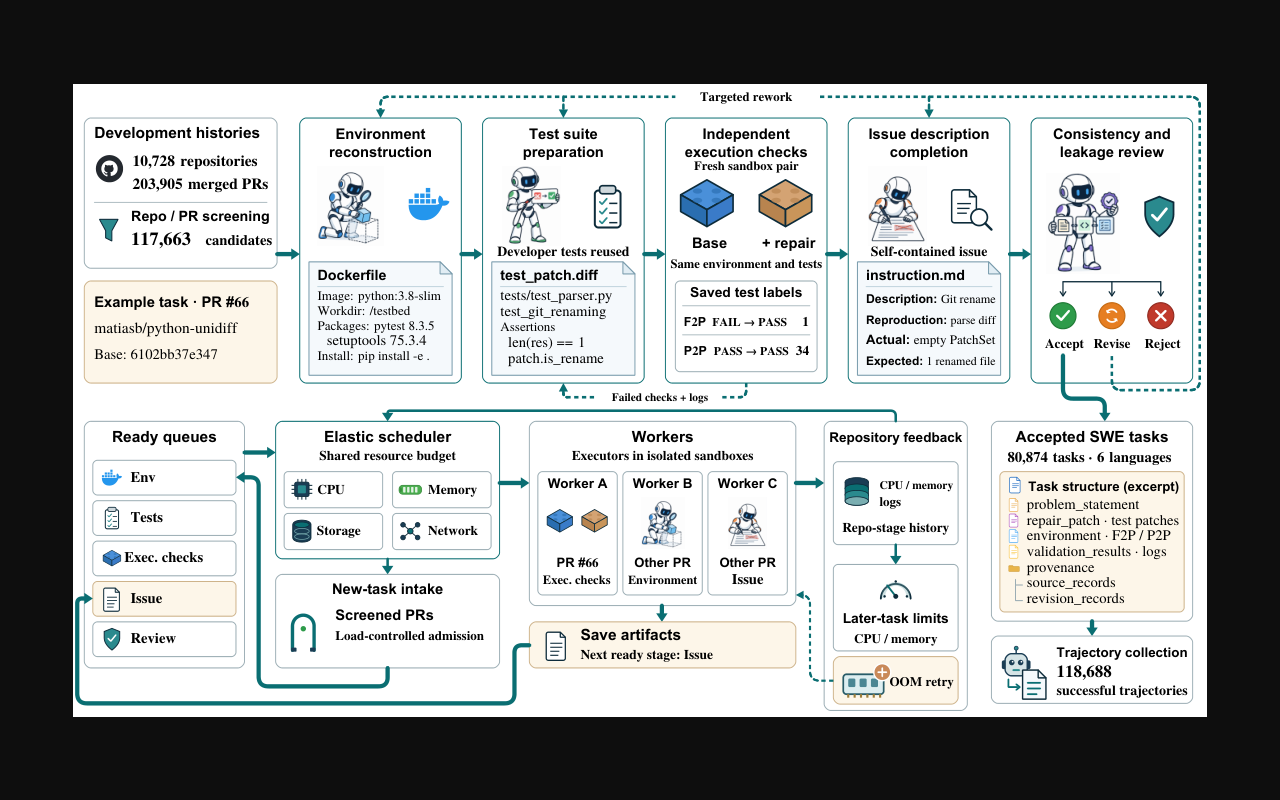
Этапы реконструкции PR, проверки исполняемой задачи и эластичного планирования.
Этапы реконструкции PR, проверки исполняемой задачи и эластичного планирования. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. Из 10 728 репозиториев получено 80 874 принятых задач. В сравнении 1000 кандидатов эластичный поток принял 670 против 592 у фиксированного и 588 у пакетного.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Это дорогая инфраструктура для производства обучающих данных; опубликованные оценки моделей используют разные протоколы.

Для моей работы. Если строить свой набор для Go-агента, проверять тесты до и после исправления и хранить причину отбраковки.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-19

SkillBrowser: Selective Skill Exposure for Scalable Skill-Using Agents

Jin Ye, Yifan Jiang, Lan-zhe Guo

Агенту с большим каталогом skills помогает поиск по запросу в момент потребности. Полный каталог в начальном prompt и статическое извлечение дают иной баланс качества и задержки.

Открыть первоисточник ↗
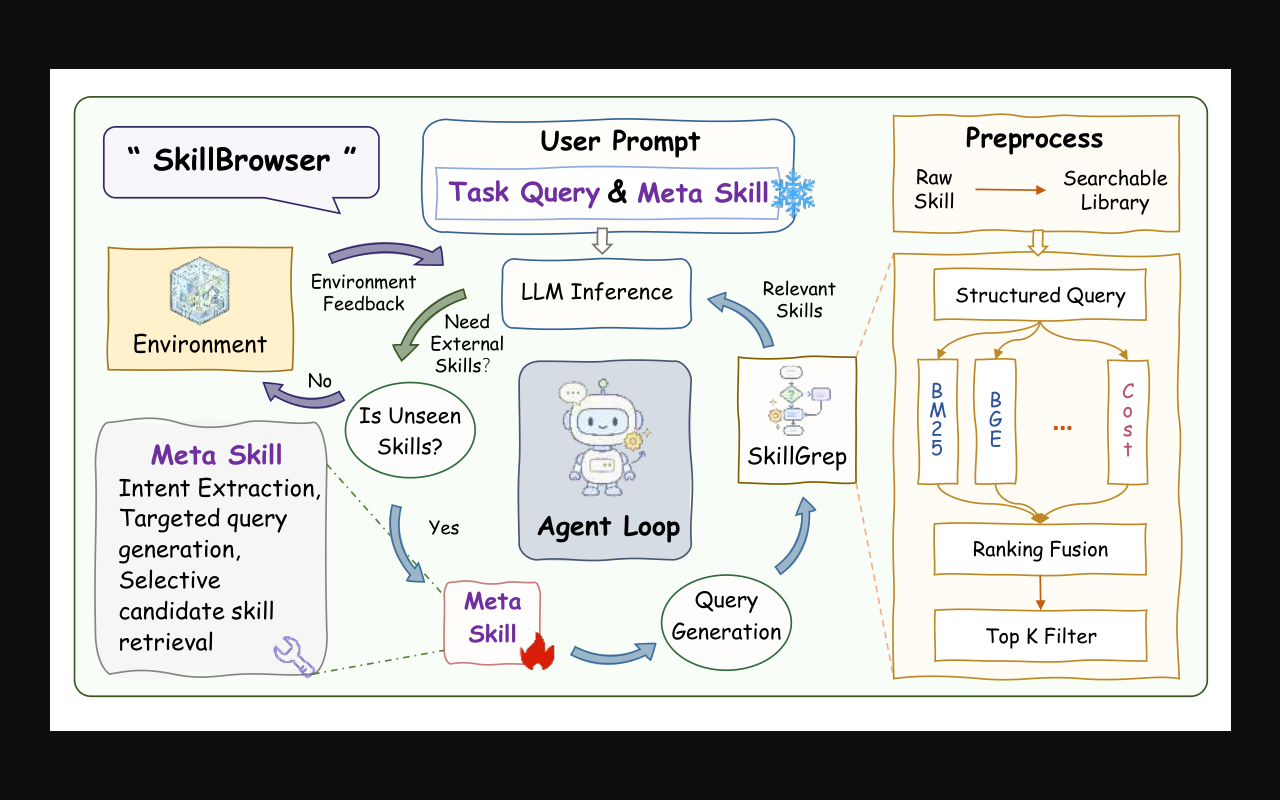
Поиск и выбор навыка в цикле SkillBrowser вместо загрузки всего каталога заранее.
Поиск и выбор навыка в цикле SkillBrowser вместо загрузки всего каталога заранее. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. На шести срезах SRA-Bench и пяти моделях SkillBrowser выиграл у статического BM25 в 26 из 30 сочетаний; общий valid-pair accuracy 78,59% против 74,64% у статического SkillGrep.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Эффект зависит от модели; управляемый доступ добавляет задержку и не всегда экономит токены.

Для моей работы. Дать агенту инструмент поиска и загрузки навыков и отдельно считать пропущенные полезные вызовы, задержку и успех задачи.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-19

Ignored, Not Refused: What Low Prompt-Injection Success Rates Hide in Small Tool-Using Agents

Farhan Zarif, Kazi Shahid Ahmed Galib, Synthia Akter Promi и др.

Низкая успешность prompt injection у небольшого tool-using агента часто означает, что он проигнорировал инструкцию или не сумел действовать. Одной метрики attack success недостаточно.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Аудит 33 000 траекторий одиннадцати моделей 2–14B на InjecAgent и AgentDojo разделяет игнорирование, отказ и выполнение атаки.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Бенчмарки синтетические; распознавание атаки выводится из видимой траектории, а не из внутреннего состояния модели.

Для моей работы. В security eval одновременно считать завершение полезной задачи, успех атаки, отказ и невалидные вызовы.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-19

Self-Evolving Agents Can Repair Failures but Struggle to Generalize from Them

Weixiang Zhao, Yichen Zhang, Yanyan Zhao и др.

Самообучение на неудачах может исправлять исходную задачу, но редко улучшает новые. Новое правило агента стоит принимать только после проверки на отложенных задачах.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Авторы сравнили память, навыки и правки harness на нескольких интерактивных benchmark, скрыв метки и ответы для failure-only режима.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Режим намеренно исключает положительные примеры; задачи веба и симуляции не равны сопровождению репозитория.

Для моей работы. Для agent memory хранить связь правила с источником и запускать независимый regression set перед повышением версии.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-19

VulnSAGE: Adjudicating SAST Reports by Connecting LLM Reasoning to Program Structure

Jinbao Chen, Zixiang Zhou, Yu Zhang и др.

VulnSAGE связывает вывод об уязвимости с проверяемыми отношениями программы и пробует воспроизвести положительные находки. Такой способ полезен для аудируемого triage.

Открыть первоисточник ↗
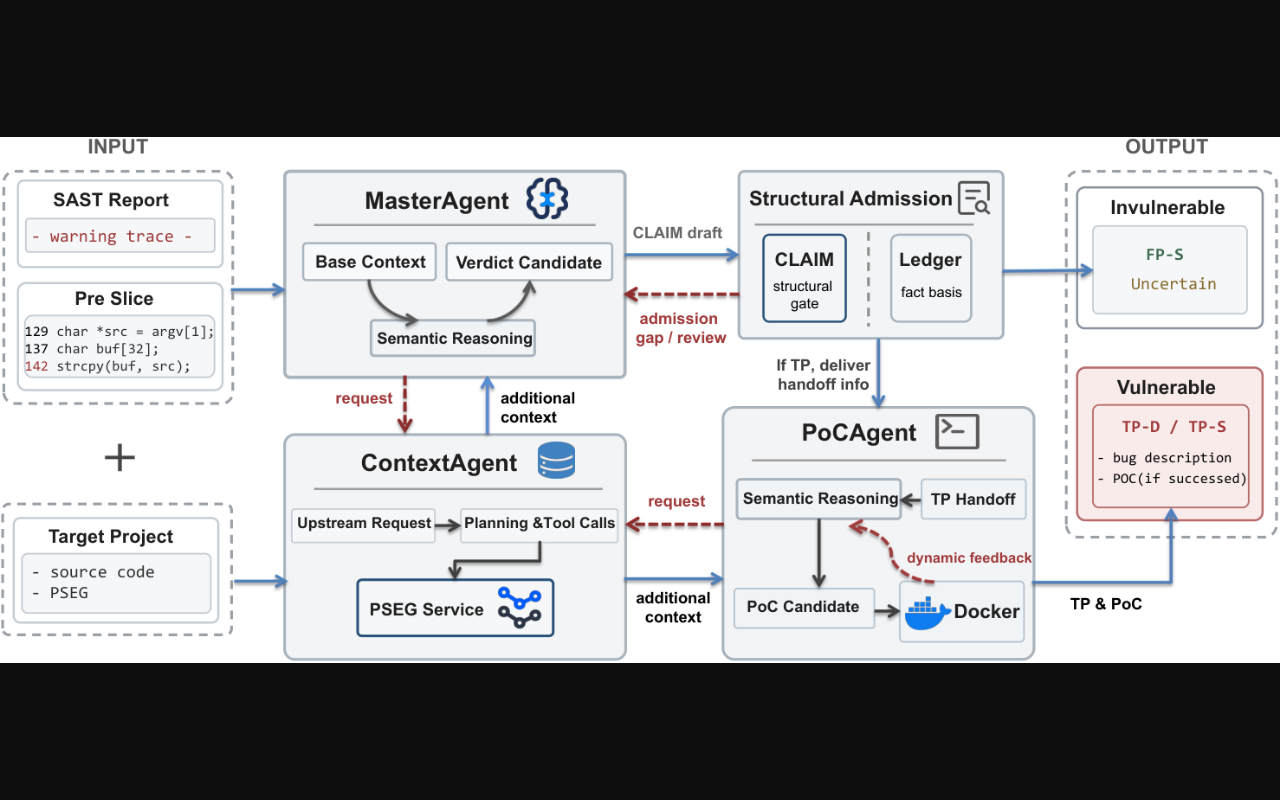
Путь отчёта SAST через проверку структурных связей и воспроизведение дефекта.
Путь отчёта SAST через проверку структурных связей и воспроизведение дефекта. Источник
Основание, ограничение и следующий шаг

Что показали / как устроено. На 187 размеченных C/C++ отчётах система отвергла 89 из 97 ложных тревог и сохранила 85 из 90 реальных дефектов.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Пять классов дефектов и C/C++ frontends; 104 воспроизведения получены среди 154 исполняемых кандидатов, а перенос на Go остаётся гипотезой.

Для моей работы. Проверять цитируемые call/data-flow связи и запрашивать воспроизведение для важного security finding.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

agents · 2026-10-16

ToolBottleneckBench: Measuring Tool-Agent Performance under Controlled Pressures and Fixed Harness Budgets

Zichuan Xu, Yuyang Dong, Makoto Onizuka, Chuan Xiao

ToolBottleneckBench показывает, как размер меню инструментов и ограничение длины вывода меняют успех агента. Вывод полезен при проектировании шлюза и самого eval: бюджет harness влияет на измеряемую способность модели.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. В основном сравнении рост меню с 8 до 128 схем снизил успех на 12,3 процентного пункта при маршрутизации. В шести конфигурациях с частой обрезкой рост лимита вывода с 1024 до 16 384 токенов сократил штраф с 43,7 до 2,7 пункта.

Основание. Эксперимент и сравнение авторов в препринте; вывод привязан к первоисточнику.

Ограничение. Эффект лимита не универсален: одна модель теряла 18,1 пункта почти без обрезки. Во внешнем ToolSandbox расход вырос, а падение успеха на 2,9 пункта статистически не подтверждено.

Для моей работы. В собственной оценке менять размер каталога, лимит вывода и стратегию выбора инструментов по отдельности; считать успех вместе с токенами.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

White papers и технические отчёты 0

В этом выпуске материалов раздела нет.

Инженерные разборы 2

backend · 2026-10-14

Designing failover across OpenAI model providers

OpenAI Developers

Резервный маршрут к модели должен выбираться для конкретной повторяемой операции. Статья даёт практический перечень условий для безопасного переключения между провайдерами.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Это архитектурное руководство OpenAI: эквивалентность возможностей, дедлайн, пропускная способность, бюджет, контроль данных, ограниченный retry и постепенный возврат.

Основание. Практический опыт и рекомендации команды OpenAI; вывод привязан к первоисточнику.

Ограничение. Измерений доступности нет; незавершённые agent-сессии и вызовы с неясным побочным эффектом нельзя слепо переиграть.

Для моей работы. Взять одну самодостаточную read-only операцию и испытать сбой, переключение и возврат с ограничением трафика.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

backend · 2026-10-14

Maintaining software with the GPT-6 family | OpenAI Developers

OpenAI Developers

Команда OpenAI описала масштабную уборку устаревшего кода с помощью Codex и проверяемых свидетельств. Это практический кейс для небольших, легко проверяемых PR.

Открыть первоисточник ↗
Основание, ограничение и следующий шаг

Что показали / как устроено. Внутренний отчёт команды: пять инженеров слили более 1400 cleanup PR и удалили свыше 800 тысяч строк; отдельный тест сравнивает принятые находки и стоимость двух моделей.

Основание. Практический опыт и рекомендации команды OpenAI; вывод привязан к первоисточнику.

Ограничение. Это самоотчёт одной команды без публичного репозитория и контролируемого baseline общих результатов; модель иногда предлагала лишнюю сложность.

Для моей работы. Начать с небольшой области; подтвердить неиспользуемость конфигурацией, историей, телеметрией и косвенными потребителями, затем открыть проверяемый PR.

Следующий шаг. Прочитать метод и проверить тезис на своих задачах до внедрения.

Первоисточник ↗

Практические руководства 0

В этом выпуске материалов раздела нет.

Инструменты и важные изменения 0

В этом выпуске материалов раздела нет.

Что проверить на следующей неделе

  1. Добавить в agent eval проверки поведения harness и вызовов инструментов.
  2. Сравнить статическую и управляемую загрузку навыков на своих задачах.
  3. Измерять успешность полезной задачи рядом с защитой от prompt injection.
Увеличенная иллюстрация из первоисточника

Первоисточник ↗